22 octobre 2026 · Gilles Maury
Un deuxième SaaS ne devrait ajouter que ce qui lui est propre
Quand on lance un deuxième SaaS, on découvre une chose désagréable : presque tout ce qui rend le premier fiable est à refaire. Les sauvegardes, la supervision, les certificats, la gestion des secrets, la procédure de mise en ligne, les preuves à fournir à un client ou à un auditeur.
Si chaque projet les reconstruit à sa façon, vous n'obtenez pas trois SaaS solides. Vous obtenez trois SaaS, trois niveaux de sécurité différents, et aucun qui soit vraiment tenu.
La carte ci-dessous répond donc à une seule question : dans un SaaS déployé, qu'est-ce qui appartient au projet, et qu'est-ce qui se construit une fois pour tous ?
Une précision avant de commencer
C'est une architecture cible. Elle est écrite décision par décision — les ADR 014 à 034 du dépôt Sluis, publics, avec à chaque fois les alternatives écartées et les points encore ouverts — et elle se valide étape par étape. Elle n'est pas encore en production.
Je la publie à ce stade précisément pour qu'on puisse en discuter avant qu'elle soit figée. Une architecture qu'on ne montre qu'une fois construite est une architecture qu'on ne peut plus corriger.
Lire la carte en trente secondes
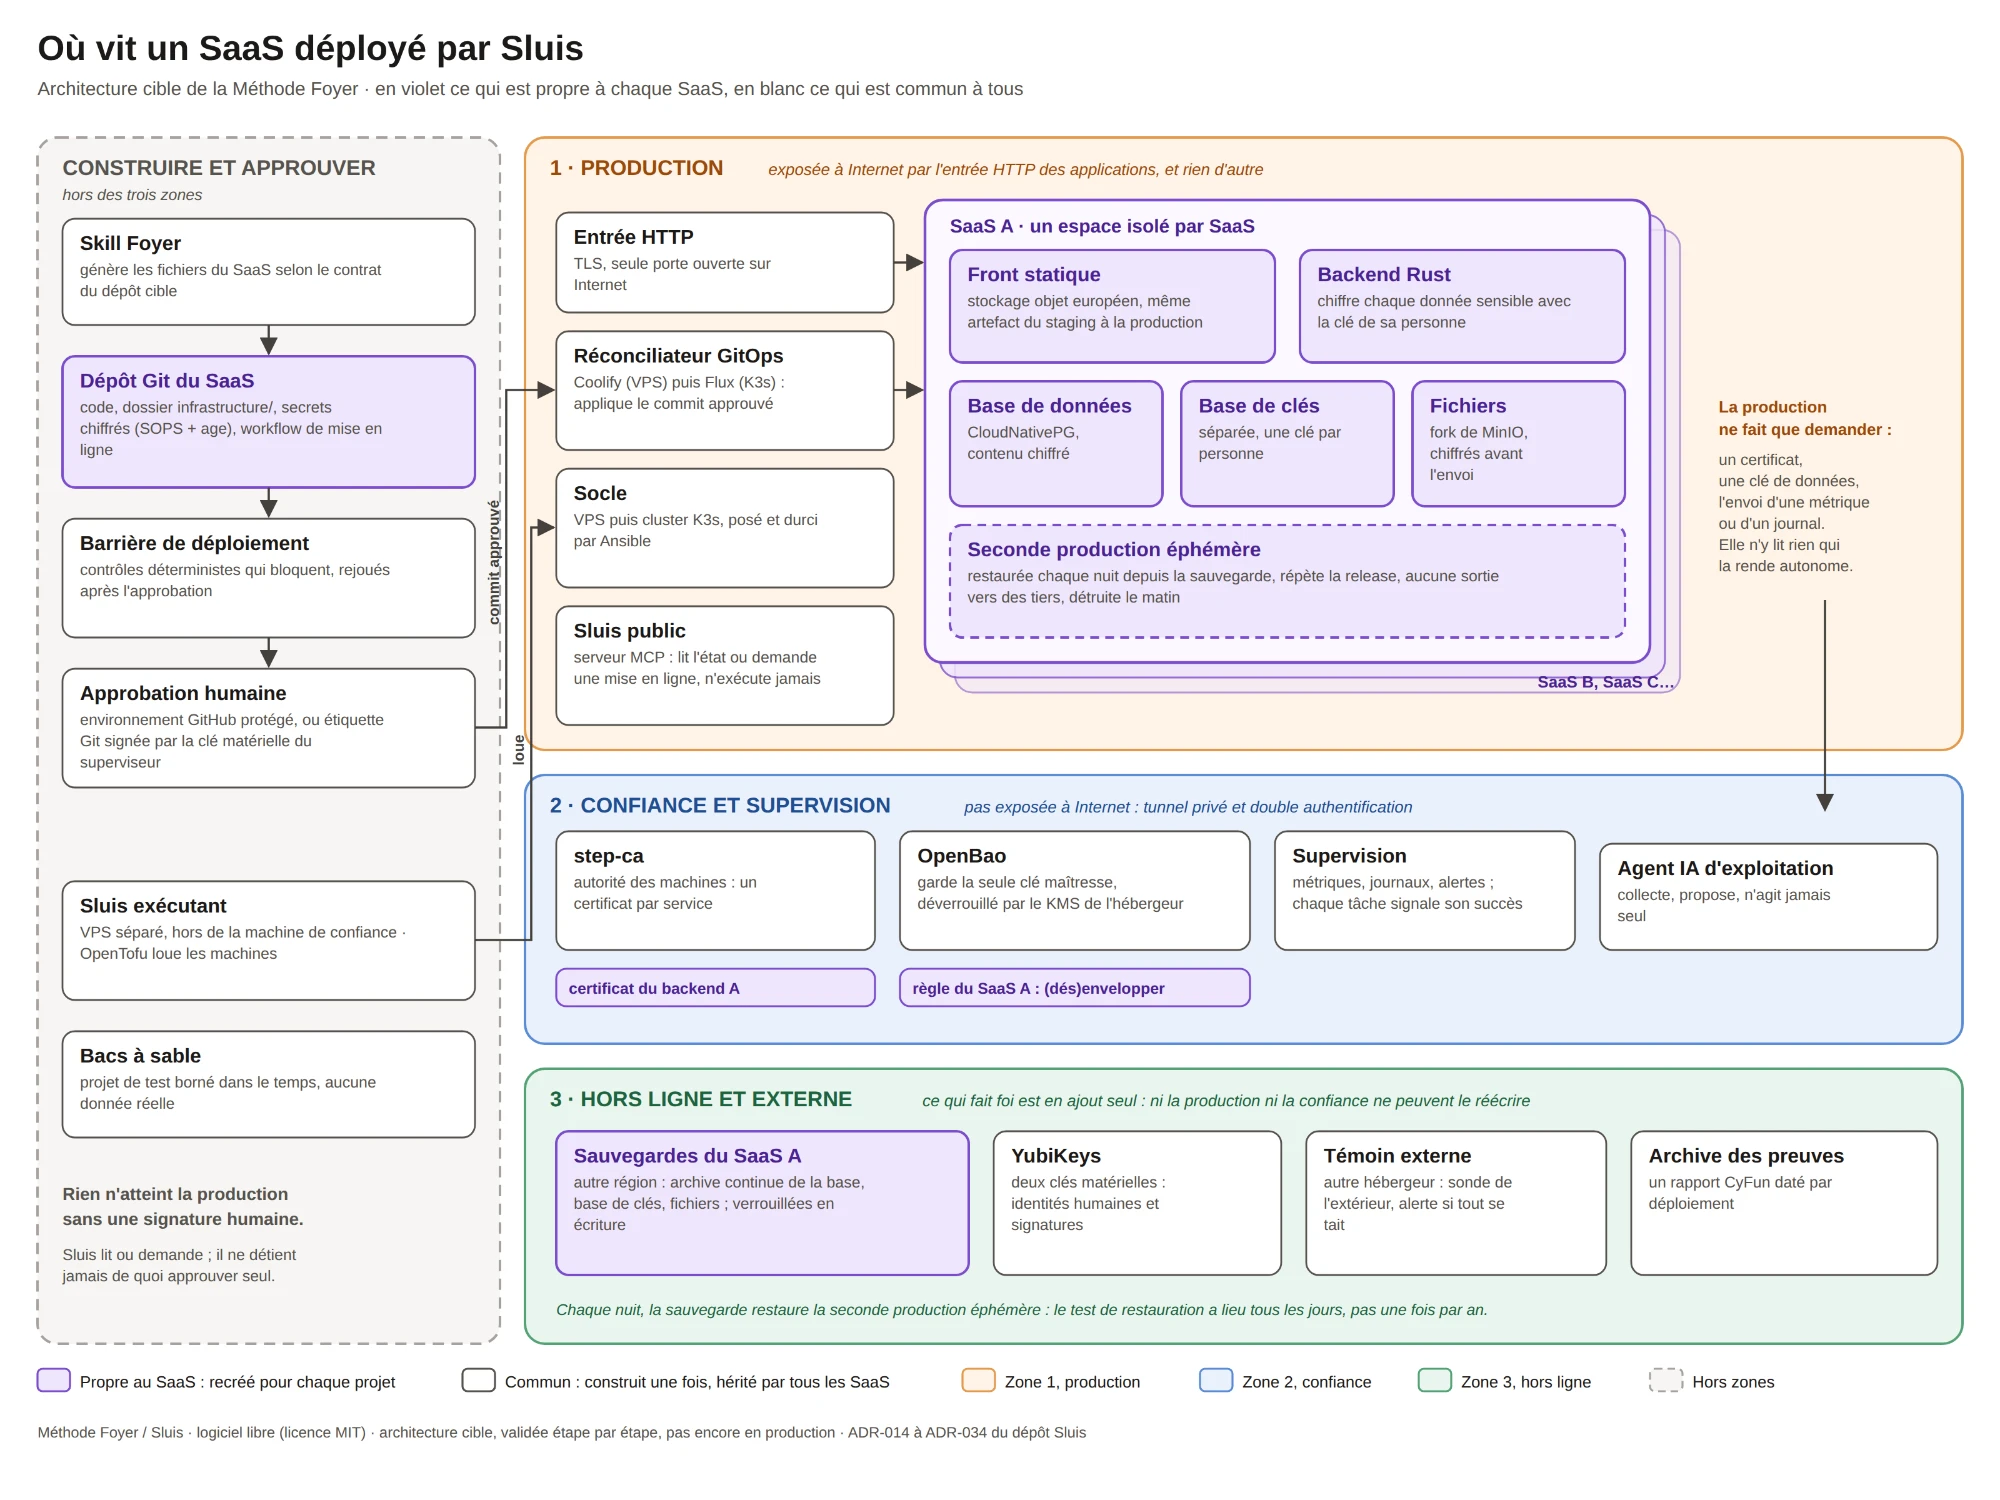
Elle se lit sur deux axes (cliquez pour agrandir) :
La couleur du fond dit où vit chaque brique — et donc quels pouvoirs elle a. La zone 1, en orange, c'est la production : exposée à Internet, par l'entrée HTTP seulement. La zone 2, en bleu, c'est la confiance et la supervision : jamais exposée, accessible par tunnel privé et double authentification. La zone 3, en vert, c'est le hors-ligne et l'externe : ce qui fait foi. Et hors zones, en gris, là où l'on construit et où l'on approuve.
La couleur des boîtes dit à qui appartient chaque brique. En violet, ce qui est propre au SaaS et recréé pour chaque projet. En blanc, ce qui est commun : construit une fois, hérité par tous.
Si vous ne retenez qu'une chose : quand on ajoute un SaaS, on n'ajoute que des boîtes violettes. Tout le blanc est déjà là.
Trois zones, trois règles
Les zones ne servent pas à faire joli. Chacune porte une règle de circulation, et ce sont ces règles qui protègent — pas les outils qui les peuplent.
La production ne fait que demander. Elle demande un certificat, une clé de données, ou envoie une métrique. Elle ne lit jamais, dans la zone de confiance, rien qui la rendrait autonome. La conséquence est la seule qui compte pour vous : la production détient les données chiffrées, la zone de confiance détient la clé qui les ouvre, jamais les deux au même endroit. Un attaquant qui prend la production repart avec du chiffré.
La zone de confiance n'écrit en production que par la voie approuvée. Pas de session d'administration ouverte en permanence sur les serveurs. Tout changement passe par Git, par l'approbation humaine, puis par le réconciliateur.
Ce qui fait foi est en ajout seul. Sauvegardes verrouillées en écriture, journal des preuves, témoin externe hébergé ailleurs. Même un attaquant qui tiendrait la production et la zone de confiance en même temps ne pourrait pas réécrire l'histoire : ni effacer les sauvegardes, ni maquiller les journaux.
C'est la règle que je place au-dessus de toutes les autres : aucune brique ne détient tout.
Ce qui est propre à chaque SaaS, et pourquoi
Le violet, c'est ce qui porte les données et le métier d'un projet. Il est isolé pour deux raisons, et la seconde intéresse directement vos obligations légales.
L'étanchéité. Une compromission du SaaS A ne donne rien sur le SaaS B : autre espace, autre base, autre stockage, autre règle dans le coffre, autre certificat.
L'effacement. Chaque personne a sa propre clé de chiffrement, rangée dans une base de clés séparée de la base de données. Effacer une personne — le droit à l'effacement du RGPD — c'est détruire sa clé. Ses données deviennent alors illisibles partout où elles traînent encore : base en service, répliques, archives, sauvegardes.
Le gain est considérable, et il est rarement dit : vous n'avez plus à aller chercher une personne ligne par ligne dans des sauvegardes que vous ne voulez surtout pas modifier. Et comme les sauvegardes de la base de clés sont conservées moins longtemps que celles des données, la durée de rétention des clés fixe un délai d'effacement maximal — que vous pouvez annoncer dans votre politique de confidentialité, et tenir.
La contrepartie est assumée plutôt que cachée : la fenêtre d'effacement n'est pas nulle. Entre la destruction de la clé et l'expiration des dernières sauvegardes qui la contenaient, il s'écoule un délai. Ce délai se publie ; il ne se dissimule pas.
Ce qui est commun à tous, et pourquoi
Le blanc, c'est tout ce qui coûte cher à bien faire et qu'on fait mal quand on le refait à chaque projet : l'autorité de certification, le coffre à clé maîtresse, la supervision, la chaîne d'approbation, les sauvegardes hors région, le témoin externe, la collecte des preuves.
Construit une fois, il sert à tous. Et surtout il s'améliore une fois pour tous : le jour où la supervision apprend à détecter un nouveau problème, tous les SaaS en profitent le lendemain.
C'est aussi ce qui rend tenable une ambition de conformité élevée quand on est seul. Je vise pour mes SaaS le niveau Essential du référentiel belge CyberFundamentals — j'explique ailleurs pourquoi cette cible. Refaire ces mesures projet par projet serait impossible. Héritées de la plateforme, elles deviennent un coût fixe, pas un coût par projet.
Le chemin d'une mise en ligne
Suivez la colonne de gauche de la carte, de haut en bas :
- La skill Foyer génère les fichiers du projet. Elle ne les exécute pas.
- Sluis vérifie que le dépôt respecte le contrat. Il ne les écrit pas. Celui qui écrit n'exécute pas ; celui qui exécute n'écrit pas.
- La release est d'abord jouée sur la seconde production éphémère.
- La barrière de déploiement passe ses contrôles : configuration sans dérive, supervision vivante, sauvegarde récente et restauration réussie, images signées. Oui ou non — pas de « presque ».
- Un humain approuve, avec une signature que la machine ne peut pas produire seule.
- Juste avant l'exécution, la barrière est rejouée. Si quelque chose a changé entre l'approbation et l'exécution — une sauvegarde qui a échoué entre-temps, une supervision qui s'est tue, une configuration qui a dérivé — le déploiement s'arrête et l'approbation est annulée. Rien n'est retenté automatiquement : l'humain réapprouve, en connaissance de cause.
- Le réconciliateur applique le commit approuvé, et seulement lui.
- Un rapport daté part dans l'archive des preuves : qui a approuvé, quand, quel commit.
Le principe derrière ces huit étapes tient en une phrase : ce qui demande ne peut pas approuver. Ni l'agent IA, ni Sluis ne détiennent de quoi mettre en ligne seuls.
Trois choix qui surprennent
Le staging, c'est la vraie production, restaurée chaque nuit. Chaque nuit, la production est restaurée ailleurs depuis la sauvegarde hors site, base de clés comprise, et un échantillon de données y est déchiffré. Le test de restauration a donc lieu tous les jours, et pas une fois par an dans la panique — c'est exactement le manque que je pointais en examinant la sécurité d'un serveur existant, où la restauration n'avait jamais été éprouvée depuis ailleurs. La release du lendemain s'y répète sur des données réelles. Cette copie n'a aucune sortie réseau vers des tiers, elle est protégée comme la production, et elle est détruite chaque matin. Si la restauration échoue, ou si elle ne tourne pas, une alerte part. Les tests de charge et la recette, eux, se font ailleurs, sur des données factices.
L'agent IA collecte et propose ; il n'agit jamais seul. Le contenu d'une alerte peut être écrit par l'attaquant. Un agent qui lit ce texte et dispose de droits d'action est une porte d'entrée, pas un gain de productivité. Ici il rassemble les preuves et rédige une proposition ; l'humain décide. C'est le même principe de point d'arrêt humain que pour encadrer l'IA dans une organisation.
Toute tâche récurrente signale son succès. Une sauvegarde qui ne tourne plus ne fait aucun bruit. Le silence ne doit donc jamais vouloir dire « tout va bien » : chaque tâche émet un signal de succès, et c'est son absence qui alerte. C'est aussi pourquoi le témoin externe vit chez un autre hébergeur — si toute la plateforme tombe, supervision comprise, quelqu'un doit encore le remarquer.
Ce que ça coûte, et les limites
Je ne vais pas vous vendre ça comme gratuit.
- Plus de pièces. Une machine de confiance, un serveur pour l'exécutant, un témoin chez un autre hébergeur, des sauvegardes dans une autre région. C'est le prix de « aucune brique ne détient tout ».
- Une cérémonie. Clés matérielles, signatures, approbations : chaque mise en ligne demande un geste humain. C'est voulu, et ça se paie.
- Des compromis assumés. Le coffre se déverrouille automatiquement grâce au service de gestion de clés de l'hébergeur : on gagne des redémarrages sans intervention, mais le secret critique se déplace chez lui. Et sur un VPS, l'hébergeur garde un accès à la mémoire de la machine — le coffre protège contre la compromission de la production, pas contre l'hébergeur.
- Une seule personne pour tenir le tout. D'où l'insistance sur l'automatisation, et sur les alertes qui signalent quand quelque chose ne s'est pas produit.
La feuille de route compte huit étapes, chacune utilisable seule. Les trois premières — identités et clés, machine de confiance, première recette sur VPS — suffisent à une première mise en production. Les étapes 4 à 7 — base répliquée et archivée, chiffrement une clé par personne, seconde production nocturne, barrière rejouée et preuves — la rendent défendable au niveau Essential. La huitième, le passage en cluster, attendra que la croissance le justifie.
Et chez vous ?
Si vous avez plusieurs projets, ou si vous en prévoyez un deuxième, trois questions valent le détour :
- Qu'avez-vous déjà refait deux fois, alors que ça aurait dû être commun ?
- À l'inverse, qu'avez-vous mutualisé et que vous regrettez, parce qu'un incident sur un projet a touché les autres ?
- Votre staging est-il restauré depuis vos vraies sauvegardes — ou croyez-vous simplement qu'elles marchent ?
Cette troisième question est celle qui, dans mon expérience, produit les silences les plus longs.
Tout est libre, sous licence MIT. Les décisions détaillées, avec les alternatives écartées et les points encore ouverts, sont dans le dossier docs/adr du dépôt Sluis. Si vous voulez qu'on regarde ce que cette carte donnerait sur vos projets, ou creuser une zone en particulier, parlons-en.