21 octobre 2026 · Gilles Maury
Sécuriser un serveur sans budget : les voyants verts ne prouvent rien
Un soir de septembre 2026, sur un de nos serveurs, le détecteur d'intrusion a levé 5 753 alertes en sept heures. Pendant ce temps, le système de bannissement a pris zéro décision.
Aucun outil n'était en panne. Le détecteur tournait, le bannisseur tournait, le contrôle d'intégrité tournait, la supervision tournait. Tous les voyants étaient au vert. Ils ne se parlaient simplement pas.
C'est le genre de constat qu'on ne fait pas en regardant un tableau de bord — seulement en allant comparer deux sources qui devraient dire la même chose.
Pourquoi ça vous concerne
Si vous faites héberger une application sur un serveur modeste — un VPS, une machine chez un hébergeur européen, un serveur de bureau —, il y a de bonnes chances que votre prestataire vous ait listé les outils installés. Pare-feu, détection, bannissement, supervision : la liste rassure.
Elle ne prouve rien.
Un outil installé et « vert » prouve qu'il est allumé, pas qu'il protège. Ce qui protège, c'est le lien entre les outils — et la preuve régulière que ce lien tient. Dans notre cas, les requêtes malformées étaient rejetées par le proxy avant d'être écrites dans son journal. Le bannisseur ne lisant que ce journal, il n'a jamais rien vu. Chaque outil faisait correctement son travail ; la chaîne, elle, était coupée.
C'est précisément ce que la plupart des audits de surface ne regardent pas.
La question à poser à votre infrastructure cette semaine
Elle tient en une phrase, et la réponse prend une dizaine de minutes :
Combien d'adresses votre détecteur réseau a-t-il signalées le mois dernier, et combien votre système de bannissement en a-t-il effectivement bloquées ?
Un écart massif entre les deux signe exactement le trou que nous avions. Si les deux chiffres se ressemblent, votre chaîne tient. Si l'un est à quatre chiffres et l'autre à zéro, vous surveillez le bruit, pas la menace.
La stratégie en six principes
Voici ce que l'incident nous a fait écrire. Rien d'exotique, rien de payant — mais un ordre et des liens explicites.
- Réduire la surface avant de la surveiller. Pare-feu fermé par défaut, seuls les ports web sont publics. L'accès d'administration passe par un tunnel privé et disparaît d'Internet. Ce qui n'est pas exposé n'a pas besoin d'être défendu.
- Un seul moteur de décision, plusieurs capteurs. Les journaux du proxy, ceux de l'accès distant et les alertes du détecteur réseau alimentent tous le même moteur, qui seul décide de bannir. Le détecteur détecte ; il ne bloque pas.
- Deux points de blocage, chacun à son niveau. Le pare-feu coupe les adresses bannies avant même qu'elles atteignent les applications ; le proxy ne garde que ce qui exige de lire la requête HTTP.
- Choisir à l'avance le comportement en panne. Si le moteur de décision tombe, faut-il tout bloquer ou tout laisser passer ? Les deux choix se défendent. Le découvrir pendant l'incident, non.
- Superviser la chaîne, pas le bruit. Une alerte doit appeler une action. On alerte donc quand un maillon casse — bloqueur déconnecté, journal muet, adresse vue mais jamais bannie — pas à chaque paquet suspect.
- Tout en code, identique partout. La configuration vit dans un dépôt git, se déploie par un script, et se vérifie par un second script qui compare la machine réelle au dépôt. Ce qui dérive se voit.
Mis bout à bout, ça donne ceci — et la lecture utile du schéma tient dans les flèches, pas dans les boîtes (cliquez pour agrandir) :
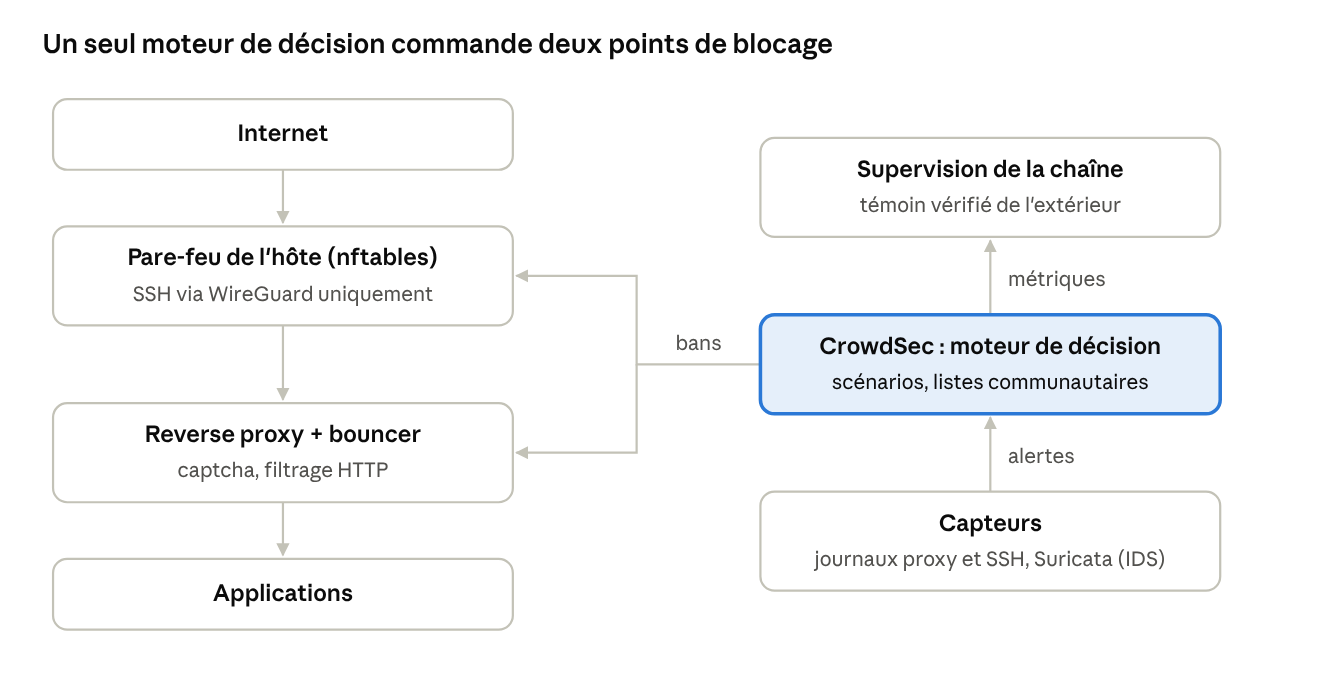
À gauche, le trafic et les deux points où on le coupe. À droite, la boucle qui décide. C'est la flèche « bans », de la droite vers la gauche, qui manquait le soir des 5 753 alertes : tout le reste existait déjà.
Cinq pièges, et l'astuce qui va avec
Ce sont nos propres cicatrices, publiées telles quelles — avec la parade, parce qu'elle est le vrai livrable :
- Le bannissement ne voit que ce qui est journalisé. 5 753 alertes, zéro décision : le cas d'école ci-dessus. L'astuce : ne jugez jamais une chaîne sur une seule source, croisez-en deux indépendantes. L'écart est le diagnostic.
- Un pare-feu applicatif ne protège pas les conteneurs. Docker insère ses propres règles en amont de celles que vous écrivez. L'astuce : accrochez-vous à la chaîne prévue pour ça, et vérifiez-le en tentant une connexion depuis l'extérieur plutôt qu'en relisant la configuration.
- La supervision peut mourir sans prévenir. Prometheus arrêté onze jours, pendant que l'Alertmanager tournait et donnait le change. L'astuce : un témoin vérifié depuis l'extérieur de la machine — qui surveille le surveillant, puisque lui ne peut pas signaler sa propre absence.
- Une alerte toujours rouge est une alerte éteinte. Le contrôle d'intégrité signalait 166 changements légitimes chaque nuit ; au bout de quelques semaines, plus personne ne la lisait. L'astuce : exclure le bruit fichier par fichier, et dater chaque exclusion — une exclusion non datée devient un angle mort permanent.
- Un bloqueur mal réglé peut tout bloquer. Le jour où le moteur de décision est tombé, tous les sites ont répondu 403. L'astuce : c'est le principe 4 — tranchez le comportement en panne à froid, et testez-le en coupant volontairement le moteur un dimanche matin.
Le fil commun des cinq : rien n'était cassé. Tout était mal relié.
Ce qu'en dit CyFun — y compris ce qui ne va pas
CyFun (CyberFundamentals) est le référentiel du Centre pour la Cybersécurité Belgique, utilisé pour mettre en œuvre NIS2. Un petit projet n'est presque jamais tenu de s'y conformer ; son niveau le plus exigeant, Essential, reste la grille de lecture la plus simple pour voir ce qui manque. J'explique ailleurs pourquoi j'ai fixé ce niveau comme cible aux SaaS que je construis.
Appliquée à une infrastructure montée de cette façon, la grille donne un verdict en deux temps — et c'est un verdict que la plupart des petites installations partagent :
| Fonction | État | Ce qui manque |
|---|---|---|
| Gouverner | Faible | Rôles, politique écrite, revue |
| Identifier | Partiel | Inventaire complet, analyse de risques |
| Protéger | Solide | Gestion des accès d'équipe, formation |
| Détecter | Solide | Journaux centralisés et conservés |
| Répondre | Faible | Un plan d'incident écrit et testé |
| Récupérer | Partiel | Une restauration testée depuis ailleurs |
Autrement dit : bon pour empêcher et pour voir, insuffisant pour gouverner, réagir et se relever.
La récupération mérite qu'on s'y arrête, parce que c'est le piège le plus courant et le plus silencieux : avoir des sauvegardes qui fonctionnent, et une restauration qui part du même centre de données. C'est notre cas, et c'est celui de beaucoup de monde. Un incident qui emporte le datacenter emporte alors aussi le plan B. L'astuce : tant qu'une restauration n'a pas été réellement exécutée depuis ailleurs, chronomètre en main, ce n'est pas une sauvegarde, c'est une intention.
Le prochain gain ne viendra pas d'un outil de plus. Il viendra d'un document de plus — un plan d'incident écrit — et d'un exercice de restauration mené pour de vrai.
Ce que la gratuité ne couvre pas
Les outils sont libres et gratuits. Le reste ne l'est pas, et il vaut mieux le savoir avant :
- Le temps. Relier, trier, lire, ajuster les exclusions une par une. C'est le vrai prix, et il est récurrent.
- Le stockage ailleurs. Une sauvegarde hors site se paie, forcément.
- L'humain. Quelqu'un qui sait quoi faire à 3 heures du matin — et une deuxième personne capable de prendre le relais. Une protection qui tient dans la tête d'une seule personne ne tient pas.
- La certification, si vous en avez besoin. La grille d'auto-évaluation, elle, est gratuite.
Ce que je fais de tout ça
Nous appliquons cette stratégie à nos propres serveurs avant de la proposer à qui que ce soit. Ce n'est pas un plafond à atteindre un jour : c'est le plancher sous lequel nous ne descendons plus.
Cet article décrit la cible et les pièges qui y mènent : ni l'une ni les autres ne bougent. L'avancement, lui, vit dans le dépôt, qui dit étape par étape ce qui est branché et ce qui ne l'est pas encore. C'est volontaire, et c'est la bonne division du travail : un article se démode, un dépôt se met à jour.
Un prestataire qui ne vous montre que du vert ne vous montre pas son infrastructure : il vous montre son tableau de bord.
Par où commencer
Faites le test de l'écart décrit plus haut. S'il révèle un trou, la suite se fait dans cet ordre : brancher le bannissement sur le pare-feu, alerter sur la chaîne avec un témoin externe, retirer l'accès d'administration d'Internet, faire du détecteur réseau une source de décisions — en simulation d'abord —, puis ouvrir la grille CyFun sur Gouverner, Répondre et Récupérer.
Tout est public : la stratégie complète, la recette pas à pas avec vérification et retour arrière, et les scripts, sous licence MIT. Aucune exclusion de périmètre réelle n'y figure, volontairement — elles indiqueraient à un attaquant où ne pas regarder. Le dépôt donne la méthode, pas nos angles morts.
Si vous voulez qu'on regarde votre chaîne ensemble plutôt que votre liste d'outils, parlons-en.